l
顯示具有 軟體設計 標籤的文章。 顯示所有文章

2023年7月3日 星期一

為什麼開發人員會過度設計?

July 03 23:10~23:45


▲圖1:軟體開發的三個圈圈


前言

今天學生問Teddy一個問題:為什麼會產生過度設計(Over Design)?開發人員的時間不是都很寶貴嗎,怎麼會做出「超出目前需要」的設計?

***

原因很多

造成過度設計的原因很多,常見的有:

  1. 需求不清:很多開發人員沒有機會或意願接觸業務人員或領域專家去持續釐清需求,因此在開發系統的時候,只能依據文件或是對於需求模糊的認知來做設計。因此,很可能產生存在於設計中,但卻不存在於需求中的軟體,如圖1的區域6。
  2. 超前佈署:不管需求是否明確,開發人員通常會有一種「預留彈性」的傾向。「雖然客戶現在沒有要求,但是這個地方如果可以這樣再那樣設計,套某某設計模式,以後需求改變就輕鬆多了。」
  3. 改動架構成本很高:這一點和超前佈署有關,但發生在軟體架構層面。因為軟體架構的修改成本很高,所以如果可以在架構設計階段就「留有彈性」,那未來的日子就好過多了。很可惜,此時的彈性絕大部分都是開發人員腦補的結果,不但沒有幫未來鋪路,反倒增加人為的複雜度。
  4. 展現技術能力:有時候,過度設計就僅是開發人員展現自我技術能力的結果。「08學得一身功夫,就該好好施展一番。先來個23個設計模式漱漱口。」
  5. 演化的結果:有時候系統初期過度設計並不明顯,但隨著系統不斷開發與重構,演化的結果導致系統存在一些過於彈性的設計。例如,想要code reuse與去除重複程式碼,就很容易產生過於彈性的設計。

***

結論

過度設計的原因很多,Teddy覺得主要還是對於需求的理解是否到位,以及對於改變的反應能力是否足夠,會造成開發人員有沒有信心只要當下做出「將將好的設計」(Just Enough Design)即可。從敏捷開發的角度來看,採用TDD/BDD/SBE的開發方法,可以讓 (Specification = Test) = Program,在理想狀況下,可以大幅減少過度設計。

***

友藏內心獨白:要做到Lean,並不容易。

2023年6月14日 星期三

為什麼Teddy沒使用Specification設計模式?

June 14 21:46~22:53


  ▲圖1:定義Specification介面


前言

在6/5~6/7去客戶家上【領域驅動設計與簡潔架構入門實作班】的時候,有一位學員問Teddy:

  1. 為什麼Teddy建議Entities Layer的物件不要直接操作Repository?
  2. 為什麼有人說UoW(Unit of Work)和Repository在DDD裡面算是Anti-Pattern?
  3. 為什麼Teddy沒有用Specification模式?

前兩集談了前兩個問題,今天討論最後一個問題:「為什麼Teddy沒用Specification設計模式」」?


***

Specification 設計模式

這一個設計模式是由Eric Evans與Martin Fowler所整理的,可在此下載介紹該模式的pdf檔案。

Specification這個名字很容易讓人聯想到規格或是需求,但它的用作其實是Filter(過濾器)或Selector(選擇器)。傳統上,開發一般CRUD-Based的系統,開發人員很常直接下SQL操作資料庫去尋找所需的資料。但是在領域驅動設計(DDD)中,強調透過領域模型來表達業務邏輯。「尋找符合條件的領域物件」這件事,本身就是一個業務邏輯,因此在領域模型中應該有相對應的物件來表達這樣的業務邏輯。而Specification設計模式就是為了這樣的應用場景而存在。

實作Specification很簡單,它的介面只有一個方法isSatisfiedBy,請參考圖1。isSatisfiedBy接受一個物件(通常是領域物件,例如Board, Workflow, Card這些物件),如果物件的內容滿足concreate specification所指定的條件,則回傳true,代表這個物件「符合規格(選到這個物件了)」。

***

圖2是以個用來選擇Board是否屬於某個Team的規格,稱為BoardBelongToTeamSpecification。


▲圖2:BoardBelongToTeamSpecification範例程式 


圖3為BoardBelongToTeamSpecification的使用方法,首先呼叫getBoardLise()產生四個Board。然後產生BoardBelongToTeamSpecification instance,傳入”Team 1”當作查詢條件。接著用BoardBelongToTeamSpecification 當作過濾條件,從這四個Board裡面選出Kanban Board與Board Game。


▲圖3:BoardBelongToTeamSpecification使用範例 


在Eric Evans與Martin Fowler所整理原始的文章中,Specificatoin還可以串接,形成更複雜的選擇規範。

***

為什麼沒用Specification?

由上面例子可以看出來,Specification其實就是一個Predicate。從實作面的角度來看,可以直接用Lambda來完成。Specification之所以存在,還有一個很重要的作用力,就是要重複使用這個業務邏輯。你可以用Specification去資料庫中挑選資料,或是驗證領域模型物件是否符合否項業務規格。在這種情況下,如果使用Lambda來實作,就會產生重複程式碼。

寫到這裡,還是沒講為什麼在ezKanban中並沒有使用Specification。原因如下:

  • ezKanban透過撰寫合約的方式來驗證領域物件的正確性,而非使用Specification。
  • 如果要透過Specification去資料庫挑選資料,那麼資料必須先從資料庫中載入記憶體或是用某種映射的方式,把傳給isSatisfiedBy()方法的物件身上的每一個欄位,去匹配資料庫中的欄位。因為ezKanban支援State Sourcing與Event Sourcing,無法光用傳統State Sourcing的方式如果採用Specification去資料庫比對資料。因此,ezKanban就沒有使用Specification,而是針對不同儲存方式與不同資料庫,用資料庫相依的方法,撰寫特別的查詢物件。
  • ezKanban套用CQRS,而CQRS和Specification是兩種互相衝突的設計模式。詳細原因請參考Vladimir Khorikov的部落格文章 <CQRS vs Specification pattern>。

***

結論

Teddy當年在學DDD的時候,印象中只有在DDD藍皮書中看到Specification的介紹,在比較接近實作的DDD紅皮書與DDD橘皮書中,沒什麼印象提到Specification。可能是Teddy學藝不精,所以開發ezKanban的時候潛意識中就沒有套用Specification。

但Teddy目前沒用也不代表以後不會用,反正這麼多設計模式,多了解一點也沒什麼不好。等到哪天有合適的場合,這些模式會自動跑出來報效國家。

***

友藏內心獨白:用Collection操作資料還是非常方便滴。

2023年6月12日 星期一

該不該使用Unit of Work和Repository?

June 12 15:48~16:20;20:22~22:56


▲圖1:ezKanban的Repository介面 


前言

昨天提到6/5~6/7到客戶家上【領域驅動設計與簡潔架構入門實作班】,有一位學員問Teddy的三個問題:

  1. 為什麼Teddy建議Entities Layer的物件不要直接操作Repository?
  2. 為什麼有人說UoW(Unit of Work)和Repository在DDD裡面算是Anti-Pattern?
  3. 為什麼Teddy沒有用Specification模式?

昨天談了第一個問題,今天聊聊第二個問題:「在DDD中,UoW和Repository要不要使用」?


***

Unit of Work(UoW)

Unit of Work和Repository這兩個設計模式都出自於Martin Fowler所寫的《Patterns of Enterprise Application Architecture》。Unit of Work顧名思義就是工作單元,什麼叫做工作單元?就是把一連串的工作步驟,視為「一個單元」、「一整包完整的大步驟」。一個工作單元隱含一個交易邊界(transaction boundary)。

舉個例子,在ezKanban裡面,有以下幾個使用案例:

  • CreateBoardUseCase
  • CreateWorkflowUseCase
  • CreateStageUseCase
  • CreateCardUseCase

每一個使用案例,都是一個工作單元,形成一個交易邊界。產生一個Board是一個工作單元,要嘛成功,要嘛失敗。同理,產生Workflow、產生Stage、產生Card,都是一個工作單元。很簡單,對不對!

ezKanban團隊使用ezKanban的領域模型開發了看板桌遊,這是另一個Bounded Context。在看板桌遊中,有一個CreateKanbanGameUseCase用來產生新的看板遊戲。這個使用案例的實作,呼叫上述四個使用案例。現在問題來了:「在看板桌遊的Bounded Context中,CreateKanbanGameUseCase是一個工作單元,它的執行要嘛成功要嘛失敗。但是因為CreateKanbanGameUseCase的實作方式是重複使用CreateBoardUseCase、CreateWorkflowUseCase、CreateStageUseCase與CreateCardUseCase,這四個使用案例各自是一個工作單元,要怎麼把它們用另一個更大的工作單元包起來?」

Unit of Work設計模式就是要解決這個問題,簡單講,就是把transaction manager注入給使用案例,而不是讓使用案例自己去控制。如此一來,最外層的使用案例負責控制transaction的開始與結束,內部的使用案例只是接受這個由最外層使用案例所注入的transaction manager。如此一來,便可以因應不同使用情境(Context)的需要,動態決定工作單元的範圍。

***


為什麼不要使用Unit of Work?

如果不管DDD,Unit of Work是一個很棒的設計模式。但是,在DDD中,Aggregate已經形成了一個交易邊界。如果在DDD中需要使用Unit of Work,則代表在某個Context底下,需要把好幾個不同的Aggregate放在同一個交易中。這不就和原本在DDD中「Aggregate形成了交易邊界」互相衝突了。

更進一步來看,在DDD中,Aggregate由Repository負責儲存與讀取。而「理論上」一個Repository可以各自採用不同的資料庫來儲存Aggregate。也就是說,如果你願意,可以將Aggregate當成一個微服務來佈署。如果在DDD中使用Unit of Work,則這些被放在同一個Unit of Work的Aggregate,就代表它們要綁在同一個資料庫中(除非使用distributed transaction,但採用這種做法的人很少,因為會造成效能問題),這就造成不同的Aggregate透過資料庫產生耦合。因此,Teddy覺得在DDD中,不應該使用Unit of Work。

***

Repository可以用嗎?

在Martin Fowler的《Patterns of Enterprise Application Architecture》書中,Repository代表Collection-Based的儲存體。也就是說,只要從Repository拿出物件,之後對於該物件的修改,會直接反應回Repository,使用者不需要呼叫save方法來儲存該物件。

在Vaughn Vernon所寫的《Implementing Domain-Driven Design》,進一步將Repository的實作分成Collection-Based Repository與 Curd-Based Repository。圖1為ezKanban所設計的Repository介面,採用Crud-Based Repository。ezKanban的所有Aggregate所對應的Repository都是採用相同的介面,只有findById, save與delete這三個方法。

不管是Collection-Based或是Crud-Based,Teddy主張,只要固定Repository介面,將其限制在單一Aggregate的新增、修改、刪除、查詢,這樣子使用Repository並不會有什麼太大的問題。

但是,實務上經常可以看到,很多開發人員在Repository身上加了很多查詢方法。如此一來,雖著需求演進,Repository的介面越來越肥大。你可以說,這種使用Repository的方式,違反了單一責任原則、開放封閉原則,以及介面隔離原則。

所以,只要固定Repository介面,將其餘查詢方法另外設計(在ezKanban中採用Inquiry設計模式來解決這個問題),在DDD中使用Repository是沒有問題的。

***

結論

以上,是Teddy近幾年開發ezKanban所累積的經驗。Unit of Work比較簡單,ezKanban壓根就沒使用過它。但是,針對Repository的使用方法ezKanban團隊重構了好幾次。一開始Teddy也是在不同的Concreate Repository中直接新增個別Aggregate所需要的查詢介面。但隨著系統越來越複雜,Repository也變得越來越亂,不容易理解其中的邏輯。後來,套用CQRS之後,把查詢、命令分離,保留最簡單的Repository介面。如此一來,使用Repository就沒有問題了。

***

友藏內心獨白:不是不好用,是你不會用 XD。

2023年6月11日 星期日

領域模型不要直接依賴Repository

June 11 19:23~20:38


▲圖1:將Repository放到Entities Layer(錯誤示範XD) 


前言

6/5~6/7到客戶家上【領域驅動設計與簡潔架構入門實作班】,有一位學員問了Teddy不少問題,像是:

  1. 為什麼Teddy建議Entities Layer的物件不要直接操作Repository?
  2. 為什麼有人說UoW(Unit of Work)和Repository在DDD裡面算是Anti-Pattern?
  3. 為什麼Teddy沒有用Specification模式?


這些問題,應該是有在下功夫研究DDD的人,才會提出來的問題。針對這三個問題,Teddy分三集來說明,今天先談第一個問題。

***

增加領域模型與測試複雜度

Entities Layer是Clean Architecture存放領域模型(Domain Model)的地方,它應該只表達問題領域的業務邏輯,儘可能與外在世界、框架無關。Repository是領域驅動設計(Domain-Driven Design;DDD)中,用來存取聚合(Aggregate)的設計模式。也就是說,Repository隔離了儲存層,讓它的使用者無需知道儲存聚合的實作細節。

Entities Layer知道Repository又怎樣?首先,這麼作讓Domain Model依賴資料存取介面,雖然這個依賴透過Repository介面做到依賴反轉,但「資料存取」的概念還是洩漏到Domain Model,增加不必要的複雜度。

這種不必要的複雜度增加,可以從測試的角度看出來。針對Entities Layer物件的測試,理想上就是傳統軟體測試所說的單元測試,而且是可以做到「測試隔離」(test in isolation)。這樣子的單元測試,因為與外在世界無關,所以可以跑得很快且可以單獨測試業務邏輯。

看到這裡鄉民們可能會想:「我有學過Test Double(測試替身),我可以在測試案例中注入Test Double,這樣就可以寫出與世隔絕的單元測試。」

使用Test Double雖然可以讓使用Repository的Entities Layer物件做到隔離測試,但是付出的代價就是單元測試變得複雜且可能出現重複程式碼。現在,要測試Entities Layer物件之間,都要在單元測試的Arrange階段先設定Repository替身,這會複雜化且重複Arrange區塊的程式碼。

***

弱化階層式架構

請參考圖1,如果將Repository放在Entities Layer,從Clean Architecture的角度來看,為了滿足相依性原則,BoardRepository必須是一個介面,然後在Interface Adapters Layer實作BoardRepositoryImpl。如此一來,雖然滿足相依性原則,卻造成了BoardRepositoryImpl跨層依賴於BoardRepository。雖然在鬆散式階層架構中允許跨層依賴,但Teddy認為這會弱化了階層式架構的一致性。

***

其他人怎麼說

請參考圖2,在IDDD書中也提到,不要將Repository注入給Aggregate。


▲圖2:Teddy的FB廢文1 


如圖3所示,在Unit Testing一書中也提到,在領域模型中直接使用資料庫(相當於Repository)會造成程式碼過度複雜。


▲圖3:Teddy的FB廢文2 


***

結論

只要程式可以正確動起來,設計沒有絕對的對、錯,但有合適程度的差別。關於這個問題Vladimir Khorikov有一篇很棒的blog: <Domain model purity vs. domain model completeness (DDD Trilemma)>,鄉民們可以參考。

***

友藏內心獨白:領域模型越乾淨越好。

2023年1月4日 星期三

也許我不會刪除你:重複程式碼不等於壞味道

January 04 00:00~01:10


前言

今年一月上班沒幾天就要過農曆年,去年底在安排泰迪軟體2023年課程表的時候,索性就把整個一月空下來。本來想要找機會再溜出國玩,後來因為去年年底太忙,沒時間安排行程,乾脆把時間拿來在家裡讀書算了。

這幾天同時間讀了幾本書,其中有一本《Five Lines of Code: How and when to refactor》滿有意思的。這是一本討論Refactoring(重構)的書,有別於傳統的重構,書中採用Rule-Based Refactoring,藉由提供幾條非常具體的規則,讓開發人員知道何時以及如何重構。例如書中的第一條規則就是這本書的書名:每一個method的程式碼不可以超過5行(不包含括號)。

今天Teddy要談這本書提到的另一個重構中經常遇到的問題,就是Duplicated Code(重複程式碼)。傳統上認為重複程式碼是Bad Smell(壞味道、怪味道),應該要將其斬草除根。關於這一點,基本上沒什麼爭議。如果程式中有很多重複程式碼,一旦需求改變涉及到這些程式碼,開發人員就需要修改每一處的重複程式碼,否則系統就會發生錯誤。這就造成另一個壞味道:Shotgun Surgery。

***

再探重複程式碼

這幾年Teddy因為學習Clean Architecture與Microservices,發現透過重複程式碼來避免模組之間的依賴,反倒是一種很常見的方法。例如,Clean Architecture的跨層原則要求Entities Layer的物件離開Use Cases Layer時必須轉成另外一種資料結構;若是往前端傳遞則轉成DTO(Data Transfer Object),往資料庫傳遞則轉成PO(Persistent Object)。雖然DTO與PO與其所相對應的Entities Layer物件並不一模一樣,重複的部分只有資料,但廣義來看這也可以視為一種重複程式碼。


《Five Lines of Code: How and when to refactor》書中對這一點解釋的很好:

Sharing code increases global behavior-change velocity, while duplicating code increases local behavior-change velocity.

針對某個功能,如果全部程式碼都共用(沒有重複程式碼),那麼當系統行為改變的時候,只要改一個地方即可,因此「global behavior-change(全域行為改變)」的速度會很快。反之,如果同一個功能每次用到它的時候都將其複製一份,那麼這份複製出來的程式碼就與原本的「本尊」獨立,去除了耦合。在這種情況下,「local behavior-change(區域行為改變)」的速度就會很快。


從生物學的角度來看,獨立的區域,例如島嶼、沙漠或高山,經常會演化出「特有種」生物。一開始這些生物的起源是相同的,但是為了應付「區域性需求」,逐漸演化出不同的特徵。 程式碼也經常如此,因為被共用的程式碼在使用它的地方可能同時存在不同的區域性需求(書中稱為local invariants),此時如果堅持「共用」,很可能導致需要回頭修改共用程式碼,讓它具備適應不同區域性需求的能力(透過設定或依賴注入),因而增加共用程式碼的複雜度,最後可能會複雜到降低它的可讀性,因而反倒造成可修改性下降(原本共用希望提升global behavior-change速度,但在這種情況下,可能反倒降低global behavior-change速度)。

***

Shotgun Surgery的問題勒?

討論至此,Teddy也不是鼓吹盲目使用「複製、貼上」來去除模組之間的依賴這樣就好棒棒,「利用重複性去除依賴」這個方法,還是要從軟體架構與邊界這兩個角度來考慮。假設你發生重複性的邊界是在同一個method裡面,這種重複性幾乎可以斷定是壞味道,可以用Extract Method將其移除。如果發生重複性的邊界是同一個package,則也有很大的機會是壞味道。但是如Teddy前述的情況,在Clean Architecture的跨層原則之下,重複性的邊界已經是架構階層之間,此時使用重複性去除依賴爭議就比較小。

另一個常見的情況是在微服務架構中,下游微服務透過聽取上游微服務的事件,在本地端建立讀取模型(Read Model)以隔離兩個微服務之間的執行期間依賴。


***

結論

Teddy在開發ezKanban的過程中也遇到很多「是否要共用,還是利用重複性去除依賴」的設計決定,例如ezKanban支援Event Sourcing與State Sourcing這兩種狀態儲存方式,一開始ezKanban的報表先支援State Sourcing,然後再支援Event Sourcing。為了支援這兩種儲存方式,團隊在Repository的實作中套用Pluggable Adapter設計模式,整個設計簡單易懂。

等開發完成之後,團隊發現有不少報表除了撈資料的方式不同(一個下SQL另一個操作event streams),其餘產生報表的計算邏輯大致上是相同的。為了去除這些重複性,又花了不少時間重構系統。重構完成後,去除重複程式碼,但付出的代價就是設計變得更間接(因為多了一層抽象介面),也沒那麼直覺。

Teddy覺得這是一個有趣的議題,重新省視「程式碼共用」這件事,共用並不一定都是好的,想想你的中台…XD。


***


友藏內心獨白:To share, or not to share, that is the question。

2022年8月5日 星期五

套房還是雅房?

August 05 01:09~02:47

▲圖1:標準版的ezKanban支援四種報表


前言

在外租屋的朋友,如果只租一間房間,一般而言有兩種選擇:套房或是雅房。套房是包含衛浴設備的房間,雅房則沒有專屬的衛浴設備,需要和其他人共用衛浴設備。前者組金比較高,後者比較便宜。

你喜歡套房還是雅房?

如果經濟許可,當然是有專屬衛浴設備的套房比較方便。

但是,從軟體開發的角度來看,軟體開發人員應該更喜歡雅房才對啊!為什麼? 因為這樣大家才可以共用(reuse)衛浴設備。每一個房間都裝一套衛浴設備,是一種duplicated code,這是一種程式開發的怪味道(bad smells),要加以去除才對。

但是,共用就不能獨立自主啦。如果你要洗澡的時候,別人正在洗澡,你就要等待。上一個上完廁所的人衛生習慣不好,沒有沖馬桶,你上廁所的時候就要幫前一個人善後。

所以,要不要共用,不是只有一個「是否會產生duplicated code」這個因素(force),還有其他條件需要考慮。今天Teddy講一個在ezKanban裡面關於共用與去除duplicated code的故事。

***

標準看板報表

如圖1所示,在ezKanban中,支援以下四種報表:

  • Lead Time Distribution Chart(交期分布圖),由GetLeadTimeDistributionChartUseCase負責產生,它透過LeadTimeDistributionChartProjection介面跟資料庫要資料。
  • Control Chart(控制圖),由GetControlChartUseCase負責產生,它透過ControlChartProjection介面跟資料庫要資料。
  • Cumulative Flow Diagram(累積流量圖),由GetCfdUseCase負責產生,它透過CfdProjection介面跟資料庫要資料。。
  • Due Date Performance Chart(到期日績效圖),由GetDueDatePerformanceChartUseCase負責產生,它透過DueDatePerformanceProjection介面跟資料庫要資料。。

因為ezKanban同時支援State Sourcing與Event Sourcing這兩種不同的資料儲存方式,上述因此每一個產生報表的使用案例所使用的Projection介面,各自有兩種實作。State Sourcing的實作使用PostgreSQL資料庫,Event Sourcing的實作使用EventStoreDB資料庫。也就是說,四個報表有八種不同的實作。

***


看板遊戲報表

2021年7月,ezKanban團隊基於原本標準看板的領域模型加以擴充,開發看板桌遊,如圖2所示。看板桌遊支援標準版的三種報表(Lead Time Distribution Chart、Control Chart、Cumulative Flow Diagram),另外增加看板桌遊專屬的Financial Report(財務報表)。


▲圖2:ezKanban的桌遊模組所支援的四種報表


雖然看板桌遊的前三種報表和標準版的程式邏輯很像,但是有少部分不同。例如對於日期的處理,在標準版中報表的日期是領域事件產生的真實時間,但在看板遊戲中,報表的日期是遊戲中的日期,不是真實世界的時間。例如,圖3是看板遊戲的累積流量圖,X軸的時間分別是Day 8, Day 9到Day 18,這是遊戲設計的時間。圖4則是標準版的累積流量圖,X軸顯示的是真實世界的時間。兩個報表可以透過儲存在資料庫中相同的領域事件資料而產生,但關於時間的處理以及報表呈現的方式則略有不同。


▲圖3:看板遊戲的累積流量圖


▲圖4:ezKanban標準版的累積流量圖


ezKanban團隊一開始實作看板遊戲的前三張報表是直接複製標準版的程式碼,加以修改成看板桌遊的報表。因此又增加三個看板桌遊報表的使用案例,以及六支Projection的實作程式。

***

去除重複的程式碼

一開始直接複製原本標準版的程式加以修改,團隊很快就寫好看板桌遊的報表。寫完之後團隊也沒有打算要修改它,因為看板桌遊的需求並不會改變,所以雖然有重複的程式碼,對整個軟體持續開發活動並不會有什麼特別的影響。有一天團隊將開發看板桌遊的經驗整理成論文,寫到處理報表問題的地方,突然覺得:「既然報表邏輯大部分的一樣,是不是可以重構一下,拿掉重複的程式嗎?」

當然可以啊,從寫出Clean Code的角度來看,去除重複性是很基本的要求,於是團隊便安排時間重構這些產生報表的程式。

怎麼重構?首先最大的問題就是看板遊戲的報表顯示的是遊戲中的虛擬時間,因此團隊一開始採用注入一個TimeConverService的作法來轉換時間。如果是標準版的看板,就注入一個NullTimeConverService,如果是看板桌遊的報表,則注入KanbanGameTimeConverService。

但後來ezKanban也重構的「向資料庫要資料」的設計,一開始採用將查詢資料的method寫在一個ReportRepository裡面。後來覺得這樣做不好,因為ReportRepository的介面太肥大,違反了介面分離原則(Interface Segregation Principle)。此外,因為ezKanban也套用了CQRS,在查詢端套用Repository設計模式,容易和命令端套用Repository設計模式產生混淆。因此團隊把查詢端的Repository改為Projection,然後讓一個Projection身上只有一個query method,只負責一種查詢條件(等於套用了GoF的Command設計模式)。

改用Projection之後,為了解決看板桌遊處理時間的問題,團隊又在Projection設計上套了Decorator設計模式,透過KanbanGameDecorator來轉換領域事件的時間。

故事還沒完,除了原本針對State Sourcing與Event Sourcing各有一個Projection的實作,這裡面也有重複的程式碼。從產生報表的角度來看,原本Projection的設計耦合了以下兩種責任:

  • 責任1:從State Sourcing資料庫或是Event Sourcing資料庫找資料的責任。
  • 責任2:找到資料資料(找出的資料是一堆領域事件),利用這些領域事件產生相對應的報表。

不管是State Sourcing或是Event Sourcing,產生報表的邏輯(責任2)都是一樣的,因此團隊又針對責任1設計一個ProjectionPeer介面,讓責任2的程式碼只要在Projection中維持一份即可。至於每一個Projection要到PostgreSQL資料庫或是EventStoreDB撈資料,只要注入不同的ProjectionPeer實作即可。在這裡,等於又套了Adapter設計模式。


***

值得嗎?

整個重構過程,套了好幾個設計模式,完全去除了重複程式碼,也達到程式碼重用的目的,同時還滿足領域驅動設計、CQRS、Clean Architecture,真的好棒棒啊。

如果真的這麼棒,Teddy就不用寫這一篇文章了。

雖然報表重構的過程還沒結束,但也到了尾聲的階段。回顧整個過程,Teddy學習到一件很重要的事:

針對Write Model的重複程式碼,值得花時間透過重構加以去除。至於Read Model的重複程式碼,除非寫完之後有經常需要修改的可能性,否則重複就重複吧。

***

ezKanban是為了研究與學習而開發的軟體,因此才會設計成「同時支援State Sourcing與Event Sourcing」。因為這個需求,才導致操作資料庫的程式碼出現duplicated code的問題。這個問題,在一般「正常專案」應該是不會出現,因為沒有人吃飽沒事讓自己的商用軟體同時支援不同的儲存方式。

ezKanban為了這個需求,導致整個資料庫存取層的設計變得複雜許多。在一般情況下,在Write Model中,一個Aggregate對應到一個Repository介面;而該介面通常也只需要一個實作,因此不會有duplicated code。在Query Model中,一個查詢對應到一個Projection介面;同樣地,該介面也只需要一個實作,也不會有duplicated code。

所以整個結論就是:

程式碼重用和去除重複性,要看Context來決定。如果鄉民們的專案不需要跟ezKanban一樣同時支援State Sourcing與Event Sourcing(絕大部分應該都屬於這種情況),在資料庫存取層可以用更簡單、更直接的設計就好。

***

友藏內心獨白:套用設計模式的第一個原則就是,不套模式能不能解決問題?

2022年7月3日 星期日

事件溯源(6):透過Projection查詢Event Store

June 30 22:15~23:38

▲圖1:EventStoreDB的Projections畫面


前言

在領域驅動設計中套用Event Sourcing,一個Aggregate instance的資料透過Repository儲存至Event Store的event stream,讀取的時候也是以單一個Aggregate instance為基本單位。但這樣顯然不足以應付大多數系統需要查詢資料的需求,在進一步套用CQRS解決查詢問題之前,這一集先介紹如何將原本主要用來負責寫入的Event Store也拿來當作查詢資料庫使用。

***

Projection (投影)

接下來Teddy將以EventStoreDB為例,說明如何使用Event Store來查詢資料。之前Teddy提到一般使用Aggregate-ID當作event stream的名稱把Aggregate instance的領域事件存入EventStoreDB。例如一個Tag Aggregate instance,它的id等於4cc11cc7-707b-476a-801c-1b6a22a69169,那麼它的領域事件將儲存在EventStoreDB裡面名稱為Tag-4cc11cc7-707b-476a-801c-1b6a22a69169的event stream。

在EventStoreDB中,除了這種代表Aggregate instance的event stream,系統還有一些特殊的event stream:

  • $all:所有系統所產生的事件都可以在$all stream找到。
  • System projections:系統依據某些內建特定條件自動「投影」產生的stream,比較常用的有:
    • By Category($ce-):Category就是Aggregate Type,EventStoreDB會將不同Aggregate Tyee的事件投影至 $ce-[Aggregate] stream中。例如,可以從$ce-Tag stream讀到所有Tag instance的事件。
    • By Event Type($et-):將每一種event type投影成一個event stream,例如可以從 $et-TagEvents$TagCreated stream讀到所有的TagEvents$TagCreated領域事件。


***

使用Projection查詢資料

以下用查詢某一個Board有多少個Tag當成範例說明如何使用projection來查詢資料。

在ezKanban中Tag與Board靠著Tag身上的board id維持單向依賴,Board並不知道它身上一共有多少個Tag,所以無法從BoardRepository獲得Board身上有多少個Tag。而基本的TagRepository也只能依據tag id找到某一個Tag,無法找出屬於某一個Board的全部Tag。

參考圖2,要找出某個Board有多少個Tag,只要:

  1. 從$et-TagEvents$TagCreated stream讀取所有的事件,然後依據事件身上的board id當作過濾條件,就可以找到一個List<TagCreated>用來代表某個Board身上所有 Tag 的id。
  2. 跑一個for each迴圈,依據步驟1找到的List<TagCreated>呼叫TagRepository就可以找出所有這個Board裡面的所有Tag。


▲圖2:getTagsByBoardId程式碼


***


EventStoreDB Projection的優缺點

EventStoreDB的Projection是一個很強大的功能,它讓原本主要用來支援Write Model的資料庫,也可以同時做為Read Model資料庫。當然這種View Model本質上還是保有Event Sourcing的特性,也就是說要得到領域物件的「目前狀態」還是需要讀出該Read Model裡面所有的領域事件並replay它們。速度可能沒有像是採用CQRS之後,用NoSQL資料庫當作Read Model只要下一個查詢條件就可以直接把整個Read Model讀到記憶體裡面那麼快。

但是,所謂「速度比較慢(或很慢)」也許沒有人類想像中的那麼慢,還是要依據應用程式的實際狀況來判斷,在很多情況之下這種速度已經可以被接受。畢竟直接使用EventStoreDB的Projection可以很方便的產生Read Model,而套用CQRS還需要另外撰寫Projector用以在讀取端資料庫投影出Read Model,這可是一個不小的工作負擔。

另外還有一點要注意,EventStoreDB是採用非同步的方式去投影出這些Projection,也就是說這些Projection與原始寫入的領域事件之間的狀態同步是最終一致性。因此你可能會發現,為什麼有時候領域事件已經寫入資料庫中,但在是Projection裡面還讀不到相關領域事件。

***

下集預告

介紹完Event Sourcing的基本寫入以及讀取操作之後,下一集談在多人同時讀取與寫入資料的情況下,如何透過樂觀鎖定來避免資料衝突。

***

友藏內心獨白:不能下Select查詢資料一開始會不太習慣。

2022年3月21日 星期一

物件聚合與類別繼承的取捨

March 21 15:16~16:14


不是說好要少用繼承嗎?

昨天上「Design Patterns這樣學就會了–入門實作班」,講完Template Method設計模式之後Teddy問學員:「GoF不是說Favor object composition over class inheritance,但Template Method卻使用class inheritance,為什麼?你們能不能用object composition 達到Template Method的效果?」


圖1是Teddy上課時設計的Template Method範例,鄉民們一起想想看,如何用object composition來取代Template Method。


▲圖1:Template Method類別圖

***

不使用繼承的設計

圖2是使用object composition取代class inheritance的設計,原本Template Method所呼叫的primitive operations或是hook operations改呼叫實作Operation的具體類別,請參考圖3程式碼。


▲圖2:用object composition取代class inheritance (套用Command設計模式取代Template Method)


▲圖3:圖2中的ConfigParser程式示意範例


***

哪種設計比較好?

如果只從Favor object composition over class inheritance的觀點來思考,圖2套用Command設計模式的設計比較好。但是,請數一下這兩個設計所需要的類別/介面數量:

  • Template Method:如圖1所示需要3個類別:
  • Command:參考圖3,ConfigParser與Operation這兩個是固定的,要分別支援從檔案與資料庫讀取設定資料,所以需要兩種DataSource實作,因此最少需要 1 + 1 + 2 + 4 = 8個類別/介面。


從Kent Beck的建單設計(Simple Design)原則來看:

  1. Passes the Tests
  2. Reveals Intention
  3. No Duplication
  4. Fewest Elements

第4條:最少元素,達到相同的功能,在這個例子裏面Template Method(class inheritance)用了3個「元素」,而Command(object composition)則用了至少8個「元素」,因此在這裡用Template Method的設計應該是比較簡單的設計。

***

友藏內心獨白:繼承不是不能用。

2022年3月18日 星期五

領域模型 VS 資料模型

March 18 15:36~17:02

▲看板桌遊


問題

昨天在北科上軟體架構請學生練習Event Storming,有學生問Teddy:「領域驅動設計強調要建立領域模型,但我不太清楚領域模型 (domain model) 與資料模型 (data model) 有什麼不一樣?領域模型裡面物件的屬性,和資料模型的資料欄位不是很類似嗎?」

領域驅動設計強調透過開發人員與領域專家共同合作建立領域模型,而不要採用傳統資料驅動或是使用者介面驅動的方式來開發軟體。道理很簡單,但領域模型與資料模型到底有何不同,許多人並無法分辨。

今天來談這個問題。

***

資料驅動

請看圖1和圖2畫面,你會覺得這是兩個不同的軟體,還是同一個軟體?


▲圖1:ezKanban畫面


▲圖2:看板桌遊畫面 


如果從「資料驅動」的角度來看,看了這兩個圖,大部分的人會覺得這是兩個不同的系統。以圖2為例,畫面上有以下不同種類的卡片:

  • 事件卡片:Day 9那張卡片代表event card,它的背面也有資料。你可能在資料庫中設計一個event_card table來儲存事件卡片的資料。
  • 標準卡片:S開頭的卡片,如果設計一個standard_card table來儲存它的資料,則該table欄位可能包含analysis_total_work, analysis_done_work, dev_total_work, dev_done_work, test_total_work, test_done_work, day_deployed, day_ready, lead_time, subscribers等欄位。
  • 固定交期卡片:F1與F2卡片,這兩張卡片的內容與標準卡片很像,感覺可以把資料放在standard_card table,只要多增加一個card_type欄位來區分卡片種類是標準卡片還是固定交期卡片即可。
  • 技術卡片:和前兩種卡片也很像,可以把資料放在standard_card table。

看板遊戲還有骰子、Ready、Analysis、Dev、Test、Ready to Deploy、Deployed等固定的工作階段,也要設計相對應的資料庫表格來儲存這些資料。

***

至於圖1的ezKanban,卡片內容記錄的資料和看板桌遊不一樣,所以可能需要一個card table來紀錄資料,裡有可能有cardId, workflowId, laneId, description, deadline, note, estimate, assignees 等欄位。很明顯地,兩個系統的資料模型並不一樣。

***

領域驅動

如果從領域驅動的角度來看,ezKanban與看板桌遊廣義來看都屬於「看板」這個問題領域,所以它們的商業邏輯與行為很可能絕大部分是相同的。例如,從看板系統的三個核心原則來看:

  • 視覺化:視覺化團隊的工作流程與工作項目
  • 限制WIP:限制工作階段的WIP (Work In Progress)
  • 管理工作流:可以測量Lead Time與Cycle Time,看到被阻礙的工作。

這三個特性,在ezKanban與看板桌遊都成立。從領域驅動的角度來看,兩者可以視為同一個系統,共享相同的領域模型,請參考圖3,只不過前端顯示方式不同。


▲圖3:ezKanban領域模型,看板桌遊也可以共用此領域模型 


***

看到這裡鄉民們可能會想:「兩個系統的資料模型明明就不一樣啊,硬要說它們是同一個系統,那麼要如何儲存兩者的資料,資料庫要怎麼設計?」

很簡單,如果把看板桌遊視為ezKanban的一部分,那麼看板桌遊的事件卡片、標準卡片、固定交期卡片、技術卡片,就全部都是ezKanban裡面Card這個Aggregate的一種特例。只要將看板桌遊的卡片所需要的資料以JSON的格式存入Card的note欄位即可,如圖4所示。


▲圖4:標準卡片S9所需的資料,用JSON格式表達


***

結論

ezKanban因為採用領域驅動設計的方式開發,因此將看板桌遊視為看板系統的一種特例,只有前端顯示桌遊的React程式不同,後端絕大部分的功能都是一樣,不需重複開發。

但如果從資料驅動設計或使用者介面驅動設計的角度來看,後端就非常有可能變成兩個完全不同的系統,產生很多重複的工作。

***

友藏內心獨白:不管是單體還是微服務,有複雜邏輯的系統還是採用領域驅動設計比較好。

2021年9月13日 星期一

Clean Architecture是一種過度設計嗎?

September 13 11:24~11:46


▲恰如其分的設計,還是過度設計?


有一位學員問Teddy…

學員:Clean Architecture是一種過度設計嗎?

Teddy:怎麼會這樣想?

學員:我跟同事討論設計問題,同事覺得我們系統不大,如果套了Clean Architecture,這樣來看Clean Architecture算不算是一種過度設計(Over Design)?

Teddy:你知道Mac Pro嗎?

學員:知道。

Teddy:如果買到頂級的Mac Pro,一台要價超過一百六十萬台幣。這麼高的規格,請問你可以說Mac Pro是一種過度設計嗎?

學員:嗯……

Teddy:如果你買了一台頂規的Mac Pro,只是拿它來上上網,寫寫小程式,在這種情境之下你可以說這是一種「過度消費」,因為你買了你用不到的計算能力。但如果你是專業的影音剪輯人士,一台一百多萬的Mac Pro對你而言可能只是剛剛好而已,甚至還會覺得不足以應付你的工作。

***

Clean Architecture是一種過度設計嗎?

領域驅動設計是一種過度設計嗎?

Design Patterns是一種過度設計嗎?

微服務是一種過度設計嗎?

陶朱隱園是一種過度設計嗎?

高鐵是一種過度設計嗎?

以上皆非,它們都只是一種「設計」,至於這種設計是不是過度或是恰如其分,則是要看應用的情境(Context)而定。

一個事物的含意,必須放在特定的情境去解讀才有意義,才可以避免產生誤會。

***

友藏內心獨白:這就是DCI。

2021年9月10日 星期五

領域驅動設計學習筆記(22):貧血模型與充血模型(下)

September 10 03:38~04:58

▲ezKanban的Board Aggregate套用DCI之後,可以動態指派新的角色給它,以便獲得新的行為能力。


阿嬤的物件導向

DCI架構(Data, Context, Interaction)由Trygve Reenskaug和James O. Coplien所提出,這兩位都是軟體界的名人,前者是MVC(Model-View-Controller)架構發明人,後者是模式與敏捷領域的大師。Teddy今年6月曾介紹過DCI並應用它來重構DDD Aggregate:

***

傳統認為好的領域模型應該設計成充血模型(Rich Domain Model),物件身上封裝著資料與操作該資料的商業邏輯,程式比較容易閱讀與維護。貧血模型(Anemic Domain Model)則被認為是不好的物件導向設計,它將商業邏輯從物件身上抽離出來,物件行為被降級成單純的資料庫操作,因此導致商業邏輯不清、系統難以維護。

Coplien 在介紹DCI的演講中曾說過:「傳統物件導向將資料與行為封裝在一起的做法,是你阿公時代的物件導向技術。」他建議採用DCI架構,將系統區分為Data、Context、Interaction。DCI架構主張物件的行為,必須要放在特定的使用案例(Use Case)裡面來解讀,才能夠理解其意義。

舉個例子,「人」這個物件,具備「唱歌」的行為。但當一個人在唱歌的時候,到底代表什麼意義,必須從使用案例中去理解。你在KTV唱歌、在學校朝會唱歌、在當兵的時候唱歌、在求婚的時候唱歌、在失戀的時候唱歌、在遊覽車上唱歌、在無人的海邊唱歌、在選秀節目中唱歌、在監獄裡面唱歌,意義可能完全不同。在DCI架構中,將這些不同的使用案例稱為Context(情境、脈絡、上下文)。

人這個物件,只需具備資料(Data)即可。至於人到底具備哪些行為,則是在某一個特定Context中,由Context將所需行為動態「注入」到人身上。一個Context經常需要協調多個物件一起工作,這個協調的動作在DCI架構中就稱為Interaction(互動)。

***

何處惹塵埃

在上一集,Teddy將「Object is a poor man’s closure, and closure is a poor man’s object.」改寫成「貧血模型是富人的充血模型,充血模型是富人的貧血模型 。」不少鄉民不知道Teddy在瞎說什麼。

為什麼說貧血模型是富人的充血模型?從DCI(富人)的角度來看,貧血模型就是資料物件(Data Object),物件的真正行為延後到執行期間再由Context指派給它。所以,你希望物件有什麼行為,沒問題,爸爸(Context)都可以指派給你。這麼豐富的行為,領域物件還能不「充血」嗎!

為什麼說充血模型是富人的貧血模型?充血模型最佳代表,就是DDD的領域模型(Domain Model)。在DDD中,領域模型主要由一堆充滿行為的Entity、Domain Service、Value Object所構成。其中若干個Entity與Value Object依據商業規則被迫「群聚在一起」形成Aggregate(聚合),並從中找一個Entity出來當「大股頭」(Aggregate Root)號令這個「部落」(聚合)。

客戶端(漢人、老外)只可透過Aggregate Root存取內部的Entities或Value Objects,因此Aggregate Root身上會有很多行為,更是充血到爆。為什麼Teddy會說這些充滿行為的領域模型是「富人的貧血模型」?因為這些行為都是在編譯期間(Compile Time)就已經決定了,因此雖然從傳統物件導向的角度來看它們的血量都很足夠,但從DCI(富人)的角度來看,它們也只是另類的貧血模型罷了。

***

結論

世事無絕對,端看造化而定。

***

友藏內心獨白: 統領埔到底要租給誰,搞得我好亂啊 XD。

2021年9月9日 星期四

領域驅動設計學習筆記(21):貧血模型與充血模型(上)

September 09 07:29~8:30

▲Pascal這種身材應該算是充血模型,把房子都壓垮了還不充血嗎 XD


緣起

幾天前在臉書DDD台灣社團看到有人問「貧血模型」與「充血模型」的問題,問題大意如下:「假設有一個Product Entity,針對該Entity實作查詢產品功能。」

方法一:將查詢功能做在Product身上

public class Product {

private final ProductRepository repository;

public Product (ProductRepository repository) {

    this.repository = repository;

}

public Optional<Product> getProductByName(String productName) {

      return repository.findByName(productName);

}

}

***

方法二:將查詢功能做在Use Case身上

public class GetProductUseCase {

private ProductRepository repository;

public GetProductUseCase (ProductRepository repository) {

    this.repository = repository;

}

public void execute(GetProductInput input, GetProductOutout output) {

      output.setProdeuct(repository.findByName(input.getProductName()));

}

}

***

發問者認為:

  • 方法一的Product有getProductByName這個「行為」,感覺符合充血模型(Rich Domain Model)的定義。但是,讓Product直接耦合Repository好像又不太對。
  • 方法二將getProductByName從Product身上拔除,升等為GetProductUseCase,拿掉Product對Repository的依賴。但是,如此一來Product身上就光溜溜沒有行為,變成Martin Fowler所說的貧血模型(Anemic Domain Model)。

到底要怎麼做比較好?

***

不是貧血、充血的問題

關於上述問題,Teddy覺得發問者所舉的例子本質上和Product Entity屬於充血模型或是貧血模型並無直接關係,而是和CQRS(Command Query Responsibility Segregation;命令查詢職責分離)比較有關。

在方法一的所謂充血模型範例中,Product身上的getProductByName(String productName)方法,是一個Query(查詢,回傳資料但不會改變系統狀態的操作),它本來就不需要也不應該存在Product身上。從CQRS的角度來看,Entity主要是要表達Command(命令,會改變系統狀態但不會回傳值的操作),因為發問者把Command與Query耦合在Entity身上,才會有「將getProductByName放在Product身上讓Product產生對Repository的依賴」的困擾。

方法二將getProductByName升級成GetProductUseCase,它現在變成一個代表Query的使用案例,如此一來實現了CQRS。把getProductByName從Product身上拔掉,並不會讓Product變成貧血模式,反而可以讓Product專心去負責原本應該表達的「Command Model(或稱為Write Model)」。這才是DDD(領域驅動設計)要套用的地方,應用在Write Model,而不是在Read Model。

在發問者所舉的例子中,Product就只有Query而有沒任何Command,所以將Product的Query拔掉之後,Product身上就沒有其他行為了,才會誤認此時的Product變成了貧血模型。

***

本來無一物

以上情境,讓Teddy想起有一次聽 Kevlin Henney 的演講,他提到一個故事(以下為Google翻譯後經Teddy修改過的中文):.

尊貴的 Qc Na 大師與他的學生 Anton 同行。Anton希望能引起師父的討論,他說:「師父,我聽說物件是很好的東西——這是真的嗎?」Qc Na憐憫地看著自己的學生,答道:「笨學生——物件只是窮人的閉包(closures)。」

被打槍之後,Anton離開了他的師父,回到了他的小研究室,打算研究閉包。他仔細閱讀了整個「Lambda:The Ultimate...」系列論文及其同類論文,並實作了一個帶有基於閉包(closure-based)的物件系統的小型 Scheme 直譯器。他學到了很多東西,期待著告訴師父關於他的進步。

在與 Qc Na 的下一次散步中,Anton 試圖給他的師父留下深刻印象,他說:「師父,我仔細研究了這件事,現在明白物件確實是窮人的閉包。」 Qc Na 的回應是用棍子打Anton,說:「你什麼時候才學得會?閉包是窮人的物件。」

那一刻,Anton開悟了。

Object is a poor man’s closure, and closure is a poor man’s object.

***

下集待續

先講完背景故事,下一集Teddy從DCI(Data, Context, Interaction)的角度,再談貧血模型與充血模型的不同觀點。

***

友藏內心獨白:貧血模型是富人的充血模型,充血模型是富人的貧血模型 。

2021年9月5日 星期日

領域驅動設計學習筆記(20):再談Aggregate Root實作

September 05 20:00~21:30


前言

Teddy之前曾用三集談過Aggregate的基本實作注意事項:

後來在今年學了DCI之後,又從DCI的觀點將Aggregate重構一波:

今天要談的問題,在〈領域驅動設計學習筆記(6):Aggregate (中)〉曾經討論過,就是Aggregate Root應該回傳唯讀的內部Entity給客戶端。原本Teddy採用reflection-util這個工具自動產生immutable proxy。reflection-util需要使用JDK 8以及之後的版本,後來Teddy改用JDK 16之後,發現reflection-util不支援Record類別。

Record類別本身就是不可修改,其實不需要幫它產生immutable proxy。但reflection-util以為Record是一般的類別,會試圖幫它產生一個Proxy(透過子類別的方式)。因為Record類別是final,無法產生子類別,所以reflection-util就破功了。

***

替代方案1: 修改 reflection-util原始碼

▲ImmutableProxy類別透過isImmutable方法判斷哪些型別本身就是不可修改的型別


看了reflection-util的原始碼,其中ImmutableProxy類別的isImmutable用來判斷一個物件是否為Immutable,如果是就不需要幫它產生一個Immutable Proxy。由於ImmutableProxy類別本身是final,而且isImmutable又是static,因此只能修改原始碼,把Record加入判斷中,如此一來就可以在Java 16中繼續使用reflection-util。

解決了不支援Record的主要問題,又發現reflection-util不認得Teddy自己設計的final類別,如下圖所示:


▲reflection-util遇到不認識的final類別也會出錯,無法產生Immutable Proxy。

Teddy認為比較好的方式是ImmutableProxy可以接受從外部注入一個isImmutable方法,如此一來便可動態決定哪些類別原本就是Immutable,不需要再幫它們產生Immutable Proxy。

經過一番嘗試之後,雖然可以修改reflection-util,但Teddy不想自己維護一份原始碼,再加上套用Clean Architecture的情況下盡量不要在Entity Layer使用外部函式庫,所以就決定放棄這個方法。

***

替代方案2: 老師傅手工打造Immutable Proxy

reflection-util原始想法是可以幫任意物件產生一個Immutable Proxy,雖然很方便但因為功能很通用所以遇到的問題(挑戰)也比較多。Teddy本來想偷懶直接使用reflection-util,後來念頭一轉想說算了,自己動手幫Aggregate Root打造合適的Immutable Proxy。

先幫鄉民回憶一下ezKanban的領域模型,下圖是Workflow Aggregate類別圖,其中Workflow是Aggregate Root,其他類別是Entity。

▲Workflow aggregate類別圖


如下列所示,Workflow有幾個方法會回傳Lane或是List<Lane>:

List<Lane> getRootStages()
      Optional<Lane> getRootStage(LaneId laneId)
      Optional<Lane> getLaneById(LaneId laneId)

      理論上使用者不可以透過回傳的Lane或是List<Lane>來修改Workflow的狀態,否則便違反了在DDD中由Aggregate Root確保自身狀態正確性的規定。

      為了回傳不可修改的Lane,首先新增一個ImmutableLane,類別讓它實作Lane介面,如下圖所示。

      ▲代表不可修改的ImmutableLane類別

      眼尖的朋友可能看出來了,ImmutableLane套用Proxy設計模式,它包裝一個原始物件(real subject),並且攔截對原始物件的呼叫。在這裡,所有會改變Lane狀態的方法,例如removeLanes()與addCommittedCard(),ImmutableLane的實作直接丟出一個UnsupportedOperationException,透過這個runtime exception用來物件代表不支援此操作。

      接下來只要修改Workflow(Aggregate Root),讓它回傳內部Entity的時候,也就是回傳Lane或List<Lane>,傳回ImmutableLane即可,如下圖所示。

      ▲修改Workflow讓它回傳ImmutableLane

      ***

      最後寫幾個測試案例驗證Workflow回傳的Lane與List<Lane>真的是不可修改的Lane。

      ***

      後語

      「Aggregate Root回傳不可修改之內部Entity的較佳實作方法到底是什麼?」這件事在Teddy心中放了好一陣子,之前一度使用reflection-util但後來因為前述的原因就沒再使用,因此ezKanban現有的Aggregate Root並沒有嚴格遵守這條要求。

      這幾天Teddy之所以會再注意這件事,是因為前兩天ezKanban團隊與OIS團隊一起mobbing的時候,團隊在event handler裡面寫了一段程式碼,類似:

      workflow.getRootStagebyId(stageId).setWipLimit(WipLimit.UNLIMIT);

      原本設定WIP Limit會產生WipLimitSet領域事件,但是系統跑起來之後卻沒有收到這個領域事件。過了一會兒大家才想起來,啊,不可以直接操作Aggregate內部的Entity來改變Aggregate狀態,要透過Aggregate Root來改變系統狀態。所以程式要改成:

      workflow.setLaneWipLimit(stageId, WipLimit.UNLIMIT);

      ***

      人畢竟是人,如果你問Teddy:「客戶端是不是不能直接修改Aggregate內部的Entity來改變Aggregate狀態?」Teddy會不假思索的回答:「是。」但寫程式的時候,有時一恍神就會寫出下面這種錯誤的程式碼:

      workflow.getRootStagebyId(stageId).setWipLimit(WipLimit.UNLIMIT);

      所以,做人還是不要偷懶,乖乖地讓Aggregate Root回傳不可修改的內部Entity就可以避免這種程式錯誤。

      ***

      友藏內心獨白:犯錯是人的天性,能避免的錯誤還是交由系統來處理。就好像「自主健康管理」有用就不需要集中檢疫了 XD。

      2021年8月20日 星期五

      領域驅動設計學習筆記(19):DDD需要套用Unit of Work (UoW) 設計模式嗎?

      August 19 22:56~August 20 00:29


      背景說明

      昨天Teddy在【搞笑談軟工Facebook社群】提到在DDD中應該是不需要使用Unit of Work (UoW) 設計模式,鄉民A問在DDD不合適使用UoW的原因是什麼?今天談一下這個問題。

      ***

      Unit of Work設計模式

      依據Martin Fowler在《Patterns of Enterprise Application Architecture》的解釋,Unit of Work:

      Maintains a list of objects affected by a business transaction and coordinates the writing out of changes and the resolutions of concurrency problem. (Google 翻譯:維護受業務交易影響的物件列表,並協調更改的寫入和並發問題的解決方案。)

      感覺有一點抽象,Teddy舉一個ezKanban系統的例子來說明Unit of Work。

      ***

      範例說明:ezKanban與看板遊戲

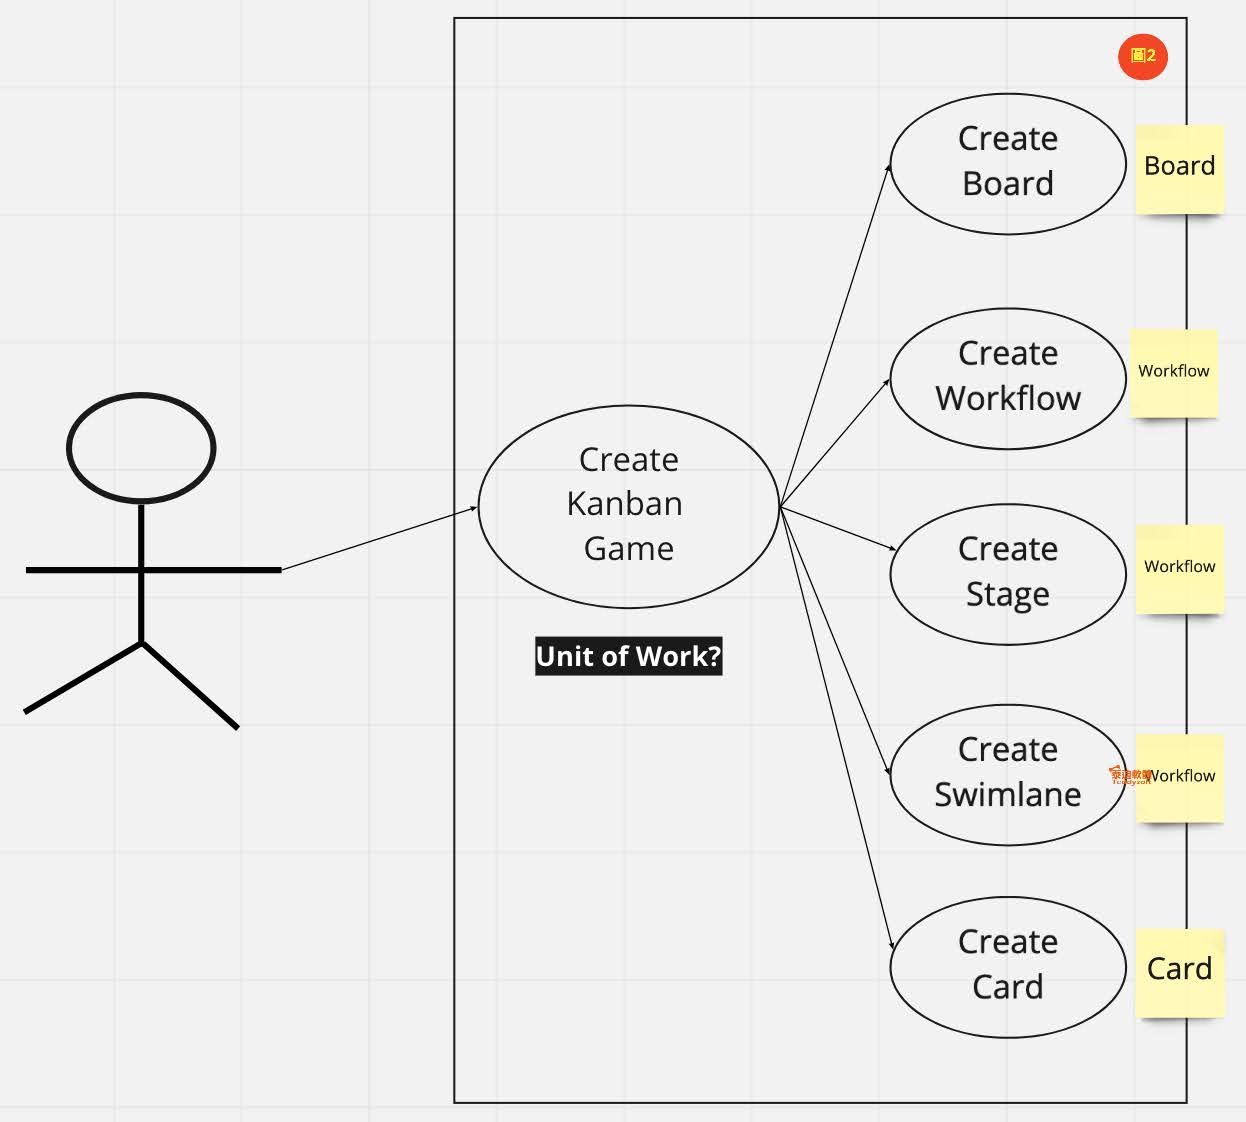
      ezKanban是一個採用DDD與Clean Architecture架構所開發的線上同時多人使用看板系統,圖1展示ezKanban的五個使用案例:Create Board、Create Workflow、Create Stage、Create Swimlane、Crate Card。其中Create Board操作Board Aggregate,Create Card操作Card Aggregate,另外三個使用案例則是操作Workflow Aggregate。


      ▲圖1


      由於在DDD中Aggregate就是一個交易邊界(transaction boundary),所以每一個使用案例都在各自的交易中處理。從這個角度來看,Aggregate本身就已經是Unit of Work,如果還需要額外套用Unit of Work,就代表有某種需求,需要在Aggregate之外再加上一層,把多個Aggregate放在一個更大的Unit of Work。

      ***

      最近Teddy與ezKanban團隊使用ezKanban系統開發一個新的看板遊戲功能,新寫了Create Kanban Game這個使用案例,請參考圖2。

      ▲圖2


      Create Kanban Game的實作方式只是呼叫原本寫好的那五個使用案例,此時有鄉民可能會認為:「是不是應該把Create Board、Create Workflow、Create Sage、Create Swimlane、Create Card放在同一個交易中處理以便確保資料的一致性?」如果真的要這麼做,就有可能套用Unit of Work設計模式。

      Unit of Work是把原本不同的工作放在同一個交易(transaction)來處理,這在傳統的CRUD系統(集中式系統)是很常見的需求。但是,在DDD中,不同的Aggregate是透過領域事件(domain event)達到狀態的「最終一致性」(eventual consistency),而不是將這些不同的Aggregate放在另一個Unit of Work中達到ACID。

      在DDD中,如果你願意,Aggregate是可以變成一個最小的部屬單位,也就是說Board、Workflow、Card可能被部署成微服務,因此自然也不適合將它們放在同一個Unit of Work(同一個交易)來處理。

      ***

      如果是同一個Aggregate…

      後來鄉民B進一步問:「如果是在同一個Aggregate的話,是不是就可以套Unit of Work?」

      例如,假設在ezKanban系統中有一個使用情境是要一次新增一百張卡片,實作方式如果是連續呼叫Create Card 使用案例一百次,這樣都是操作同一個Card Aggregate,是不是就可以把這些對於Create Card使用案例的一百次呼叫放在Unit of Work中?

      如果是這種需求,乍看之下覺得要用Unit of Work是很合理的。但是,再仔細思考一下,在DDD中「Aggregate形成交易邊界」這個特性,雖然都是相同型別的Aggregate(都是Card),但這一百張卡片是一百個不同的aggregate instance,所以嚴格講起來每一個aggregate instance應該都只管自己的交易。

      但是,這樣一來「資料正確性」怎麼辦?Teddy覺得在DDD這頂「大帽子」之下,應該儘量朝向分散式處理、最終一致性、交易補償(錯誤處理)的角度來思考系統的行為與狀態,長期而言會比較能夠得讓系統從分析、設計到實作,保持一致性與完整性。

      一旦在DDD裡面採用「Unit of Work將多個Aggregate打包處理」,Teddy大膽假設團隊中就會有人的想要在DDD中做到「分散式交易處理」或是「二段式提交(Two-Phase Commit)」的效果,如此一來思考模式又回到傳統的ACID與集中式系統的模式。

      那麼,回到根本的問題,為什要要DDD勒?

      ***

      友藏內心獨白:沒有一定不行,真的想用就用,用了也不用有警察來開罰單。

      2021年6月24日 星期四

      領域驅動設計學習筆記(18):學DCI,重構Aggregate ,Part 3

      June 24 16:20~17:14

      ▲圖1 :在Aggregate Root身上增加這兩個方法以支援動態扮演角色的功能


      前情提要

      今天是表定介紹DCI與Aggregate連載的最後一集,談如何讓Aggregate具備動態扮演不同角色的能力。

      在第一集Teddy提到在DDD的情境之下,Aggregate本身就是若干個小規模使用案例的集合體,所以實務上Teddy認為並不需要像DCI架構所建議的在不同的Context底下,讓Data object動態扮演不同的Role以執行不同功能。但為了學習目的,Teddy還是想辦法讓Aggregate具備這種動態扮演角色的能力。

      ***

      透過Java Reflection實作

      ezKanban後端以Java語言開發,Java是一個靜態型別語言,要讓物件動態扮演不同的角色,大概只能透過Reflection機制動手腳。

      Teddy的想法很簡單,在Aggregate Root身上增加圖1的兩個方法:

      • mixinBehavior:把一個物件加入behaviors list裡面,這個物件可以是任意型別的物件。
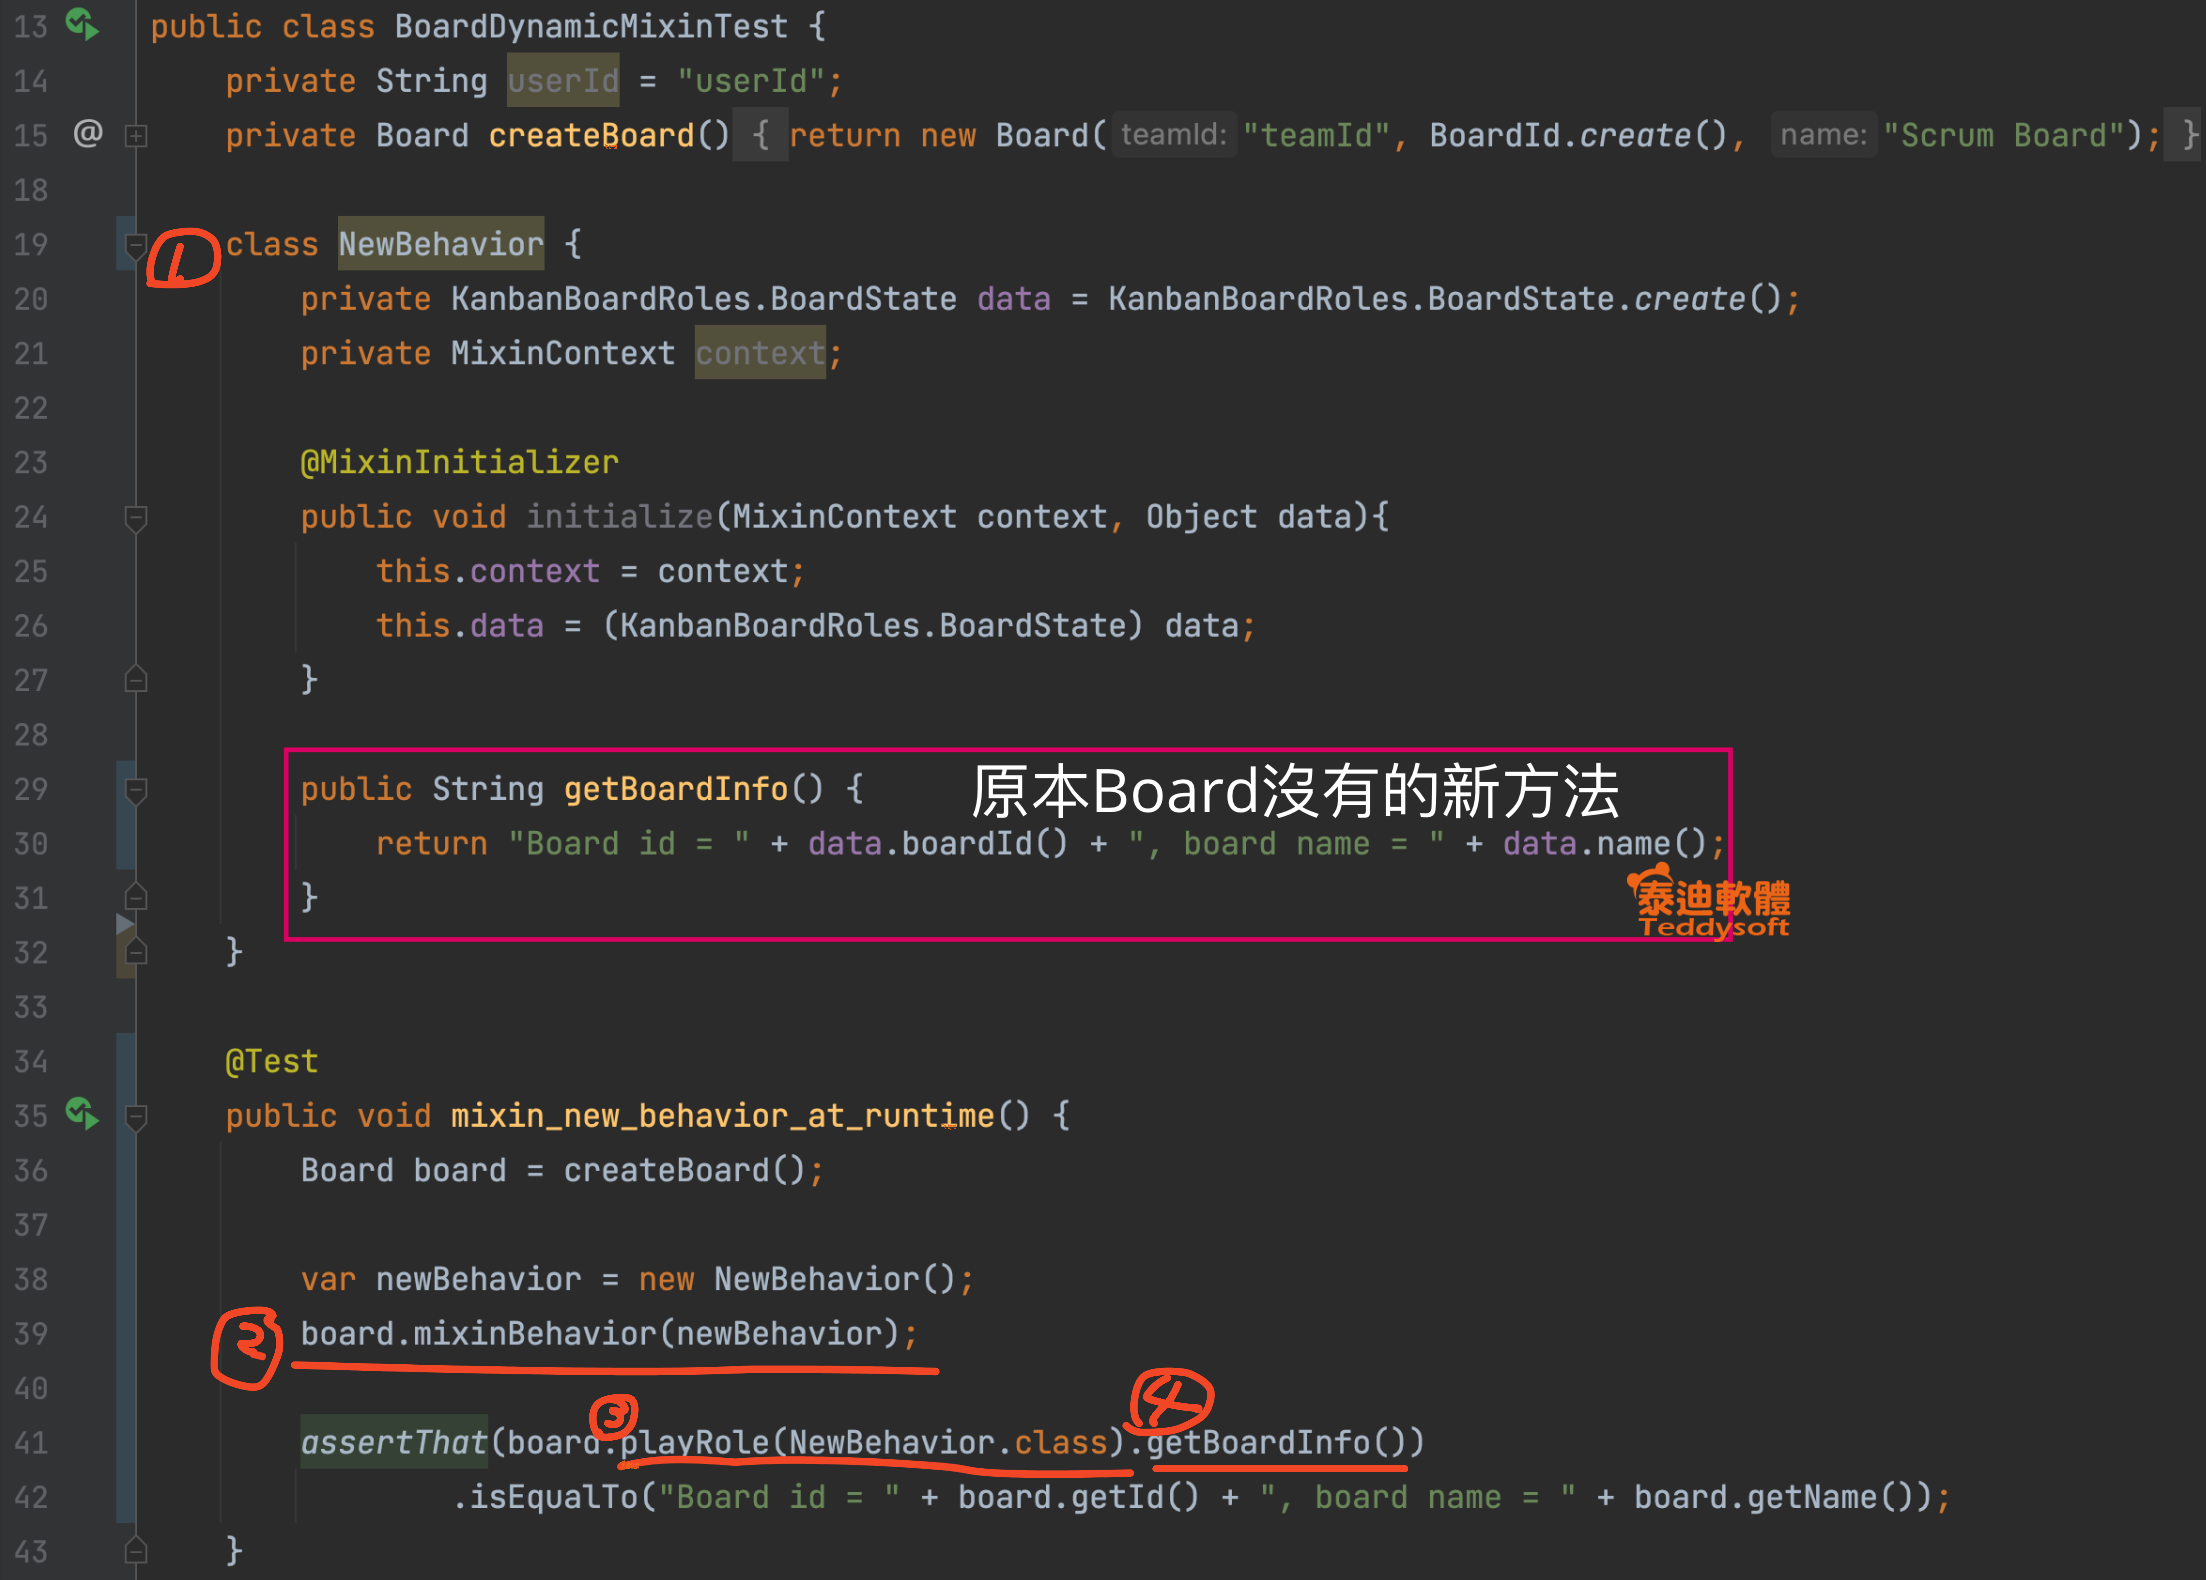
      • playRole:想讓Aggregate扮演某個角色需要先把該角色透過mixinBehavior方法加入Aggregate Root,再呼叫playRole方法,傳入參數為扮演角色的類別,這樣就可以執行該角色身上的方法。請參考圖2。


      ▲圖2:測試案例,展示如何動態加入角色到Board Aggregate Root

      以下解釋圖2程式碼:

      1. 宣告一個任意的類別叫做NewBehavior,它不用實作任何介面,就是一般的Java Class即可。它的身上有一個getBoardInfo方法,回傳一個board id 加上 board name所組合成的字串。這個類別需要獲得Aggregate Root的資料,因此它需要撰寫一個初始化的方法讓Aggregate Root呼叫,並且幫這個初始化方法貼上@MixinInitializer這個annotation。
      2. 呼叫board.mixBehavior,把newBehavior當成參數傳給board。這一行等於在程式執行期間動態指派一個角色給Board Aggregate。
      3. 呼叫board.playRole(NewBehavior.class)讓board扮演這個新的角色。
      4. 最後,可以呼叫到NewBehavior身上的getBoardInfo方法。

      ▲圖3:測試案例執行結果,當然是綠燈通過


      完整的程式還有不少細節Teddy沒有在這裡逐一解釋,不過大方向基本上就是上述的過程。

      ***

      結論

      DCI是一個很有趣的架構,而且可以和DDD與Clean Architecture一起使用,讓程式碼變得更乾淨,這是沒有問題的。

      由於Aggregate Root實際上某種程度就是一個小的DCI,所以是否需要動態指派角色給它,Teddy目前還不是很確定是否有這個需要,為了學習的目的Teddy還是花了點時間完成這個功能。

      最後,Teddy還在持續探討將DCI應用在更大的情境的可行性,例如在Saga pattern中使用DCI,等有結果之後再跟鄉民們分享。

      ***

      友藏內心獨白:動態扮演角色真的滿酷的。

      2021年6月23日 星期三

      領域驅動設計學習筆記(17):學DCI,重構Aggregate ,Part 2

      June 23 10:03~12:28

      ▲圖1:Board Bounded Context領域模型,只表示Board與Workflow這兩個Aggregate的關係。


      前言

      上一集介紹DCI架構以及它與Clean Architecture與DDD Aggregate Root的比較,今天說明如何藉由DCI的精神來重構Aggregate Root。Teddy將以ezKanban系統中,Board Bounded Context的Board Aggregate Root為例,介紹這個重構過程。

      ***

      重構前的Board Aggregate

      截圖 2022-11-04 下午1.04.39

      ▲圖2:Board重構前程式碼片段,完整的程式有七百多行


      圖1為Board Aggregate類別圖,圖2為Board重構前的程式碼片段,顯示其資料成員:

      • id:繼承自AggregateRoot物件,紀錄Board id。
      • nam:紀錄Board的名稱
      • teamId:紀錄Board屬於哪個Team
      • boardMembers:紀錄Board身上有哪些成員。
      • committedWorkflows:紀錄Board身上有哪些Workflow。Workflow是另一個Aggregate,代表看板上的工作流程。
      • boardSessions:一位使用者進入Board之後會建立一個board session,透過board session讓位在同一個Board的不同使用者可以互動。

      DCI架構要求物件不需要太聰明,只需是Data object即可,至於原先物件身上的方法則抽離出來定義在Role(角色)物件身上。接下來說明如何將Board的角色與資料抽離出來。


      ***

      定義Role介面

      根據Board所操作的資料,Teddy發現Board扮演了五種角色:

      • Content:Board的內容管理,包含board id, board name。
      • Dependency:管理Board與其他Aggregate的相依性,在此範例中只有team id。
      • Membership:Board成員管理,可以新增、刪除、查詢成員。
      • Workflow Relation:Board與Workflow關係管理,可以新增、刪除與調整Workflow順序。
      • Collaboration:管理Board身上的同時上線成員。

      接著新增KanbanBoardRoles interface,在裡面定義這五種角色,如圖三所示。

      ▲圖3:用Java interface定義Board的五種角色

      ***

      定義Data介面

      定義好角色之後很清楚發現每一種角色只使用到原本Board身上的特定資料成員,因此圖2宣告資料成員的方法很明顯的違反了介面隔離原則。所以針對每一種角色使用到的資料,在該角色內再定義一組存取資料的State介面,如圖4所示。


      ▲圖4:在每一個角色介面內定義一個存取資料的State介面


      最後宣告一個BoardState介面,讓它繼承每一個定義在Role裡面的Role-Based State介面,如圖5所示。

      ▲圖5:宣告一個包含所有Board資料的BoardState介面,要用它來取代原本宣告於Board身上的資料成員

      ***

      實作角色

      角色介面與資料介面都定義好,就可以撰寫實作角色的程式碼。說是實作但其實並非重頭開始寫,而是重構原本的Board Aggregate。重構的方式很簡單,把原本已經寫好放在Board身上分屬於不同角色的方法,搬移到各個角色身上就差不多大功告成了。Teddy把實作角色的類別稱為Behavior類別,圖6為MembershipBehavior類別程式片段,原本joinAs方法放在Board身上,重構方式只是把它從Board身上移到MembershipBehavior身上。

      由於joinAs方法原本定義在Board身上,會存取Board資料與方法,也就是說joinAs依賴Board。資料的依賴關係由第24行的State介面所隔離,行為的依賴則是由第23行MixinContext類別所隔離。State介面已於前述段落中說明,MixinContext留待下一集說明如何讓Data object支援動態扮演角色的時候再解釋。


      ▲圖6:MembershipBehavior類別實作Membership角色介面

      ***

      重構Board

      每一個角色都實作完畢之後,最後一步就是重構Board類別。參考圖7:

      • 23~26行:讓Board實作圖3所定義的五個角色,以便讓它對外維持原本的介面。
      • 28行:用BoardState取代原本的資料成員,此時BoardState相當於DCI的Data。
      • 29~32行:圖3定義了五個角色,其中DependencyRole因為只有一個getBoardId方法,所以直接實作在Board身上。其他四個角色各用一個類別實作。29~32行宣告這四個角色的資料成員,Board採用composition-deligation的方式,將客乎端呼叫Board身上不同角色的方法,轉呼叫個別的角色實作物件,請參考圖8。


      ▲圖7:重構後的Board資料成員


      ▲圖8:Board身上的joinAs方法轉呼叫membership角色的joinAs方法

      重構完畢後Board程式碼剩下約190行(原本有7百多行)。

      ***

      結論

      依據DCI「精神」重構之後,Board Aggregate的責任與介面變得很乾淨,個別角色所負擔的責任其實做程式碼也跑到相對應的行為類別身上,符合單一責任原則與介面隔離原則。可以針對個別行為單獨撰寫單元測試,增加了可測性。

      DCI架構還有一個很神奇的地方,就是希望Data object可以在不同的Context(使用案例)中動態扮演不同的角色,以執行不同的功能。Teddy將於下一集說明如何用Java語言在DDD Aggregate中實作這個動態扮演角色的特性。

      ***

      友藏內心獨白:真,單一責任原則。

      2021年6月22日 星期二

      領域驅動設計學習筆記(16):學DCI,重構Aggregate ,Part 1

      June 22 09:28~11:08


      DCI簡介

      最近三個月陸陸續續花了點時間研究DCI架構(Data, Context, Interaction),該架構包含三個主要元素:

      • Data:資料物件,傳統OOAD或DDD所謂的領域模型物件。DCI認為物件只需要有資料,以及存取資料的簡單方法即可。操作這些資料的演算法(methods),應該從物件身上獨立出來,放到角色(Role)身上。從這個角度來看,Data類似Martin Fowler所說的貧血模型(Anemic Domain Model)。
      • Context:實作使用案例的地方,DCI認為,物件的演算法必須放在一個特定使用情境去討論才可知道它的意義,這個情境(Context)就是使用案例。
      • Interaction:使用案例藉由指派若干物件扮演不同的角色,並協調物件之間彼此的協作來完成使用案例,稱為互動(Interaction)。角色是一個沒有狀態的物件,有點類似domain service。但在DCI架構中,Data物件可以在程式執行期間動態扮演不同角色以便獲得執行不同演算法的能力。Data物件扮演某個角色之後,該Data物件看起來就變成該角色的型別,可以執行該角色身上所定義的方法。

      乍看之下DCI好像把原本富有行為的充血模型,搞成只剩下資料的貧血模型,這不是一種物件導向分析設計的壞味道嗎?其實不然,DCI的倡導者James Coplien認為:「把資料和行為封裝在類別身上是祖父級的物件導向設計方法。」DCI的Data物件在編譯期間雖然沒有行為,但其行為是在執行使用案例時動態由Context所指派。Coplien認為唯有給定一個Context再去解讀物件身上的行為才會有意義,程式也比較容易被讀懂。

      ***

      DCI與Clean Architecture比較


      ▲圖1:Clean Architecture與DCI對應關係


      如圖1所示,把DCI對應到Clean Architecture,Teddy認為Data與Role的實作應該是位在Entity Layer,Context與Interaction則是位於Use Case Layer。

      由於Clean Architecture並沒有特別規範Entity Layer的領域物件需要如何實作,所以如果開發人員願意,當然可以用Data與Role來實作領域模型。這就好比可以用DDD的Aggregate、Entity、Value Object、Domain Service來實作Clean Architecture的Entity Layer是一樣的道理。

      ***

      DCI與DDD比較

      把DCI和DDD實作融合在一起花了Teddy比較多的時間,主要的問題在於DDD的Aggregate設計模式。Aggregate是一組物件的集合,從中指派一個物件當作Aggregate Root,所有對於該Aggregate內部物件的存取,都需要透過Aggregate Root。Aggregate同時也是交易邊界,同一個Aggregate資料存取必須發生在同一個交易之內,不同Aggregate則是透過領域事件同步狀態,達到最終一致性及可。

      若將Aggregate對應到DCI,它到底屬於Data,還是Context?

      看到這裡有人可能會覺得:「Aggregate不是放在Entity Layer的物件嗎,那就應該屬於Data啊。」在Teddy實作DDD的時候,的確是把Aggregate放在Entity Layer,但實際上Aggregate Root某種程度扮演了「多個小型使用案例」的角色。因為在設計階段決定Aggregate邊界的時候,很大部分的原因是依據「業務範圍」來決定Aggregate大小。也就是說,從業務需求的角度,若干物件的協作必須發生在同一個交易內商業規則才不會被違反,因此把這些物件放在同一個Aggregate。這樣聽起來,是不是和DCI的Context所扮演的角色幾乎一樣? 主要的差別在於,Aggregate是靜態的物件協作範圍,DCI的Context則是動態的物件協作範圍。

      ***

      下集待續

      先把背景知識介紹完,下一集Teddy將說明如何參考DCI的精神重構ezKanban系統的Aggregate。重構之後的程式變得更乾淨,符合單一責任原則與介面分隔原則。

      ***

      友藏內心獨白:天下事分分合合。